| Свежий номер №36 (413) / Аннотация геномов: от последовательности к функции Дата публикации: 24.09.2001 Михаил Гельфанд, gelfand@integratedgenomics.ru
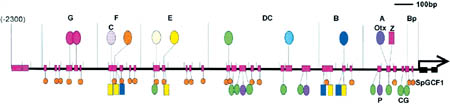
Предсказание функций Однако сравнительный подход позволяет не только размечать белок-кодирующие участки, но и предсказывать функции белков. Для этого новые белки сравнивают с белками, функции которых были исследованы экспериментально. При высоком уровне сходства можно ожидать тождества функций, при среднем сходстве - близости функций и, наконец, при отдаленном родстве угадываются только самые общие функциональные или структурные свойства. Скорость изменения белков в ходе эволюции непостоянна: некоторые семейства белков эволюционируют быстро, другие - медленно; более того, даже один и тот же белок в разных группах организмов может эволюционировать с разной скоростью. Чуть выше говорилось о тождестве функций. На самом деле это некоторая абстракция. Тонкие биохимические параметры реакций, катализируемых одним и тем же белком из разных организмов, конечно, будут отличаться. Более того, вопрос о том, что такое «один и тот же белок из разных организмов», тоже не вполне тривиален - ведь аминокислотные-то последовательности не идентичны. С экспериментальной точки зрения это означает, что если мутацией разрушить «родной» ген, а потом при помощи стандартных генно-инженерных приемов внести в геном «родственный» ген, то это не скажется заметным образом на жизни клетки - синтезируемый со вставленного гена белок заменит отсутствующий. Вычислительный же подход сводится к установлению того факта, что оба гена не просто являются потомками одного предкового гена, но и точка их расхождения совпадает с точкой расхождения видов (альтернативный вариант - расхождение генов в результате дупликации внутри одного генома; в этом случае, как правило, функции двух получившихся копий постепенно начинают различаться). Хотя понятия, которые обсуждались в двух предыдущих абзацах, были выработаны еще в семидесятых годах, они достаточно долго существовали в виде некоторых абстракций. Дело в том, что для того, чтобы объявить пару генов из двух разных геномов одним и тем же геном, необходимо, в частности, проверить, что не один из этих генов не имеет более близкого родственника в другом геноме (это один из тестов на отсутствие дупликаций в эволюции этих генов). Ясно, что такая проверка может быть проведена, только если доступны полные геномы. Геномика - еще одно модное слово, которым называют науку, изучающую наборы генов как целое. Пожалуй, одним из наиболее ярких применений вычислительной геномики 4 является метаболическая реконструкция. Дело в том, что функции примерно половины генов бактерии могут быть достоверно установлены путем сравнения с базой данных. Этого оказывается достаточно для восстановления в общих чертах метаболической карты организма, то есть описания того, какие вещества бактерия синтезирует сама, а какие должна усвоить из внешней среды, что является для нее источником энергии и т. п. После этого реконструированная карта анализируется на предмет наличия противоречий и пробелов. Их можно разрешать, изменяя критерии сходства, а также применяя другие методы. Результаты такого исследования могут использоваться в биотехнологии, агрономии, фармацевтике, медицине. Анализ метаболических потоков в промышленных штаммах дает возможность выделять узкие места, воздействуя на которые можно оптимизировать выход продукта. Ферменты, катализирующие ключевые реакции в патогенах, могут служить потенциальными мишенями для новых классов антибиотиков (см. врезку). При этом проверяют, что соответствующую реакцию нельзя обойти другими метаболическими путями, а кроме того, стараются найти белки-мишени, присутствующие в достаточно большом числе различных бактерий, что обеспечивает широкий спектр действия, и отсутствующие у человека - иначе лекарство будет токсичным. Таким образом, проводится сравнительный анализ метаболических реконструкций для больших групп организмов. Наконец, предсказание функций белков необходимо для понимания биохимической основы многих генетических болезней. Регуляторные сигналы Однако важно знать не только полный белковый репертуар организма, но и какие белки находятся в клетке в каждый конкретный момент времени. Отсюда возникает задача выделения в последовательностях ДНК регуляторных участков, определяющих начало или прекращение синтеза генов в ответ на внешние воздействия (например, тепловой шок), физиологическое состояние (недостаток или избыток тех или иных веществ), переход в новую стадию развития и т. п. Эти последовательности являются участками связывания с ДНК белков - регуляторов транскрипции. Участки связывания одного белка похожи, но не абсолютно, поэтому возникает задача выделения сигнала в наборе фрагментов, расположенных перед совместно регулируемыми генами. Сигнал определяется как слово, присутствующее, с небольшими отклонениями, в каждом фрагменте из набора (в более общей постановке - в каком-то подмножестве фрагментов). Существует множество алгоритмов выделения регуляторных сигналов. Проблема здесь в том, что характерный размер такого сигнала - 15-20 нуклеотидов, поэтому прямым перебором найти его не удается. В то же время существует много алгоритмов, достаточно хорошо работающих в относительно простых случаях. Другая сложность, значительно более важная, в том, что во многих случаях постановка задачи, описанная в конце предыдущего абзаца, не является биологически естественной. Важной и нерешенной проблемой является описание языка взаимодействий «белок-ДНК». Другим подходом к поиску плохо определенных сигналов является использование эволюционных соображений. Так, во многих случаях сигнальные участки изменяются в ходе эволюции медленнее, чем окружающие их последовательности (хотя и быстрее, чем гены). Поэтому если удается подобрать несколько геномов, находящихся на правильном эволюционном расстоянии друг от друга, то сигнальные участки выглядят как островки локального сходства. Такого рода анализ пока не поддается строгой формализации, однако в руках эксперта он является очень мощным средством. Построенное в результате распознающее правило может использоваться для поиска новых генов из той же регуляторной системы. В большинстве случаев надежность отдельных предсказаний невелика, однако в совокупности с другими методами геномного анализа, и, в особенности, в ситуации, когда доступность нескольких родственных геномов дает возможность применять сравнительные методы, такого рода анализ часто дает возможность уверенно предсказывать регуляцию генов. До сих пор речь шла в основном о бактериальных геномах, в которых регуляция генов устроена относительно просто и, даже если ген регулируется несколькими разными белками, их взаимодействием, как правило, можно пренебречь, рассматривая все регуляторные сигналы по отдельности. В геномах многоклеточных организмов регуляция транскрипции осуществляется путем связывания многих белков с наборами ДНК-сигналов. Это дает возможность тонкой настройки, зависящей от времени и внешних воздействий (рис. 3), однако компьютерный анализ таких регуляторных кассет крайне сложен. Но и здесь сравнительный подход позволяет если не детально предсказывать регуляторные эффекты, то хотя бы обнаруживать потенциальные регуляторные участки с целью дальнейшего экспериментального анализа.
Итак, основным инструментом биоинформатики, во всяком случае, той ее части, которая занимается предсказанием функций, является сравнительный анализ. Может показаться, что, тем самым, мы обречены на повторение - действительно, бесконечно сравнивая новые последовательности с известными экспериментальными данными, можно разве что обнаруживать новых представителей известных белковых семейств, регуляторных сигналов и т. д. На самом деле, это не так. Во-первых, даже простое сопоставление результатов разнородных экспериментов порождает принципиально новое знание - некоторые примеры этого были приведены выше. Во-вторых, часто в результате таких сравнений удается найти новые гены, регуляторные взаимодействия и т. д., которые затем становятся предметом целенаправленного экспериментального анализа. Наконец, в-третьих, сравнивая последовательности близкородственных организмов, например человека и шимпанзе, можно выделять последовательности, специфичные для геномов, и искать в них ключ к пониманию механизмов видообразования - в частности, происхождения человека. Ответ к задаче про старты генов. Сигнальное слово - AGGAGG, оно присутствует, с небольшими отклонениями, во всех последовательностях на расстоянии 5-11 нуклеотидов от стартового кодона. 4 (обратно к тексту) - Не исключено, что это тавтология: некоторые экстремисты, к числу которых относится и автор данной статьи, считают, что не бывает невычислительной геномики.
|